Infraestrutura de IA para empresas do Canadá e dos Estados Unidos.
A Accentrust está planejando acesso unificado a modelos e serviços de inferência para empresas do Canadá e dos Estados Unidos. Conecte o Figena, o Cilila AI ou seus próprios aplicativos a modelos adequados ao seu negócio, com controle sobre implantação, uso e custos.
Uma API. Opções de implantação para seu negócio.
Acesso a modelos, inferência gerenciada e capacidade dedicada, orientados às necessidades das empresas nos dois mercados.
Acesso unificado a modelos
Um ponto de acesso planejado para modelos selecionados, reduzindo integrações separadas e tornando claras as capacidades dos modelos e as diferenças entre provedores.
Inferência gerenciada
Um serviço planejado para associar modelos elegíveis a implantações aprovadas conforme seus requisitos de desempenho, custo e dados. Licenças, capacidade e termos de processamento serão definidos para cada implantação.
Capacidade dedicada
Uma opção futura de computação reservada e maior isolamento, com capacidade, metas de desempenho e suporte acordados para sua carga de trabalho.
Das necessidades do negócio aos dados e à computação.
Explore as camadas de armazenamento, computação e energia dos nossos planos de infraestrutura.
Armazenamento para aplicações empresariais
Registros empresariais, documentos e dados de recuperação, com locais de armazenamento, acessos e condições de restauração definidos para cada implantação.
Conectando aplicativos empresariais a modelos e computação.
A Accentrust desenvolve o Figena, nossa plataforma principal de finanças e operações empresariais, e o Cilila AI, a camada de inteligência que ajuda as equipes a compreender o contexto e avançar no trabalho. Nossa iniciativa de infraestrutura leva essa experiência ao acesso a modelos e à capacidade de inferência para empresas do Canadá e dos Estados Unidos. Seus próprios aplicativos poderão usar o serviço de modelos planejado independentemente do Figena.
- Figena
- Cilila AI
- Seus aplicativos
Gateway de aplicativos
Identidade do cliente · chaves limitadas · TLS · cotas
Políticas e seleção de rotas
Regras de modelo, região e orçamento · sem rota permitida → erro explícito
Solicitações de dados usam armazenamento; solicitações de modelos seguem uma rota de inferência aprovada.
Implantação regional aprovada
Capacidade própria ou contratada · local de processamento acordado
Armazenamento de dados
- Bancos de dados e armazenamento de objetos criptografado
- Índices de busca filtrados por permissões
- Backups protegidos e testes de restauração
Computação de IA
- Filas de inferência e agendamento de solicitações
- Instâncias GPU / CPU · recursos compartilhados ou reservados
- Registro de modelos licenciados → instâncias de inferência
Somente o contexto selecionado conforme as permissões do aplicativo chega à inferência. Os dados armazenados não são enviados automaticamente aos modelos.
Instalações e rede
Segmentação de rede · energia e refrigeração · acesso físico
Provedores de modelos autorizados
Modelos selecionados · regiões verificadas · termos de dados explícitos
- Saída validada por políticas · conteúdo mínimo necessário
- Respostas em streaming · retorno de uso atribuível
As rotas de provedores não acessam diretamente a camada de armazenamento.
As respostas retornam pelo gateway. Salvar resultados exige uma gravação autorizada separadamente no serviço de dados.
Gestão e garantia operacional
- Clientes, chaves limitadas e políticas de implantação
- Medição de armazenamento, computação e tokens · atribuição por projeto
- Gestão de chaves, auditoria de metadados e monitoramento
Gestão e telemetria abrangem as duas rotas sem conceder acesso ilimitado ao conteúdo dos clientes.
Uma integração. Liberdade para escolher.
Estamos projetando uma API de modelos para equipes no Canadá, nos Estados Unidos ou nos dois países, com formas consistentes de selecionar modelos, gerenciar o acesso e acompanhar uso e custos.
Integrações familiares
A meta de compatibilidade começa com solicitações de chat e streaming no formato OpenAI. O guia de integração indicará SDKs, parâmetros e limites validados para cada serviço.
Compare modelos adequados
O catálogo planejado apresentará versões, limites de contexto, regiões de processamento, capacidades e preços. Saídas estruturadas e chamadas de ferramentas serão indicadas apenas quando o modelo e o endpoint as suportarem.
Roteamento dentro das suas regras
O projeto limita seleção e rotas alternativas aos modelos, provedores, regiões e regras de custo que você aprovar. Sem uma rota permitida, a solicitação deve falhar de forma clara, sem cruzar limites silenciosamente.
Controle quem pode acessar
Planejamos chaves por aplicativo, acessos separados para teste e produção, rotação e revogação de chaves, além de limites de uso e orçamentos configuráveis.
Acompanhe cada solicitação
Planejamos registros e relatórios de modelos, provedores, tokens, tempos de resposta, erros e gastos, atribuídos a cada aplicativo ou projeto.
Entenda seus custos
O modelo comercial distingue uso medido de modelos, taxas de plataforma e capacidade reservada. Tarifas, regras de cobrança e limites serão apresentados antes da contratação.
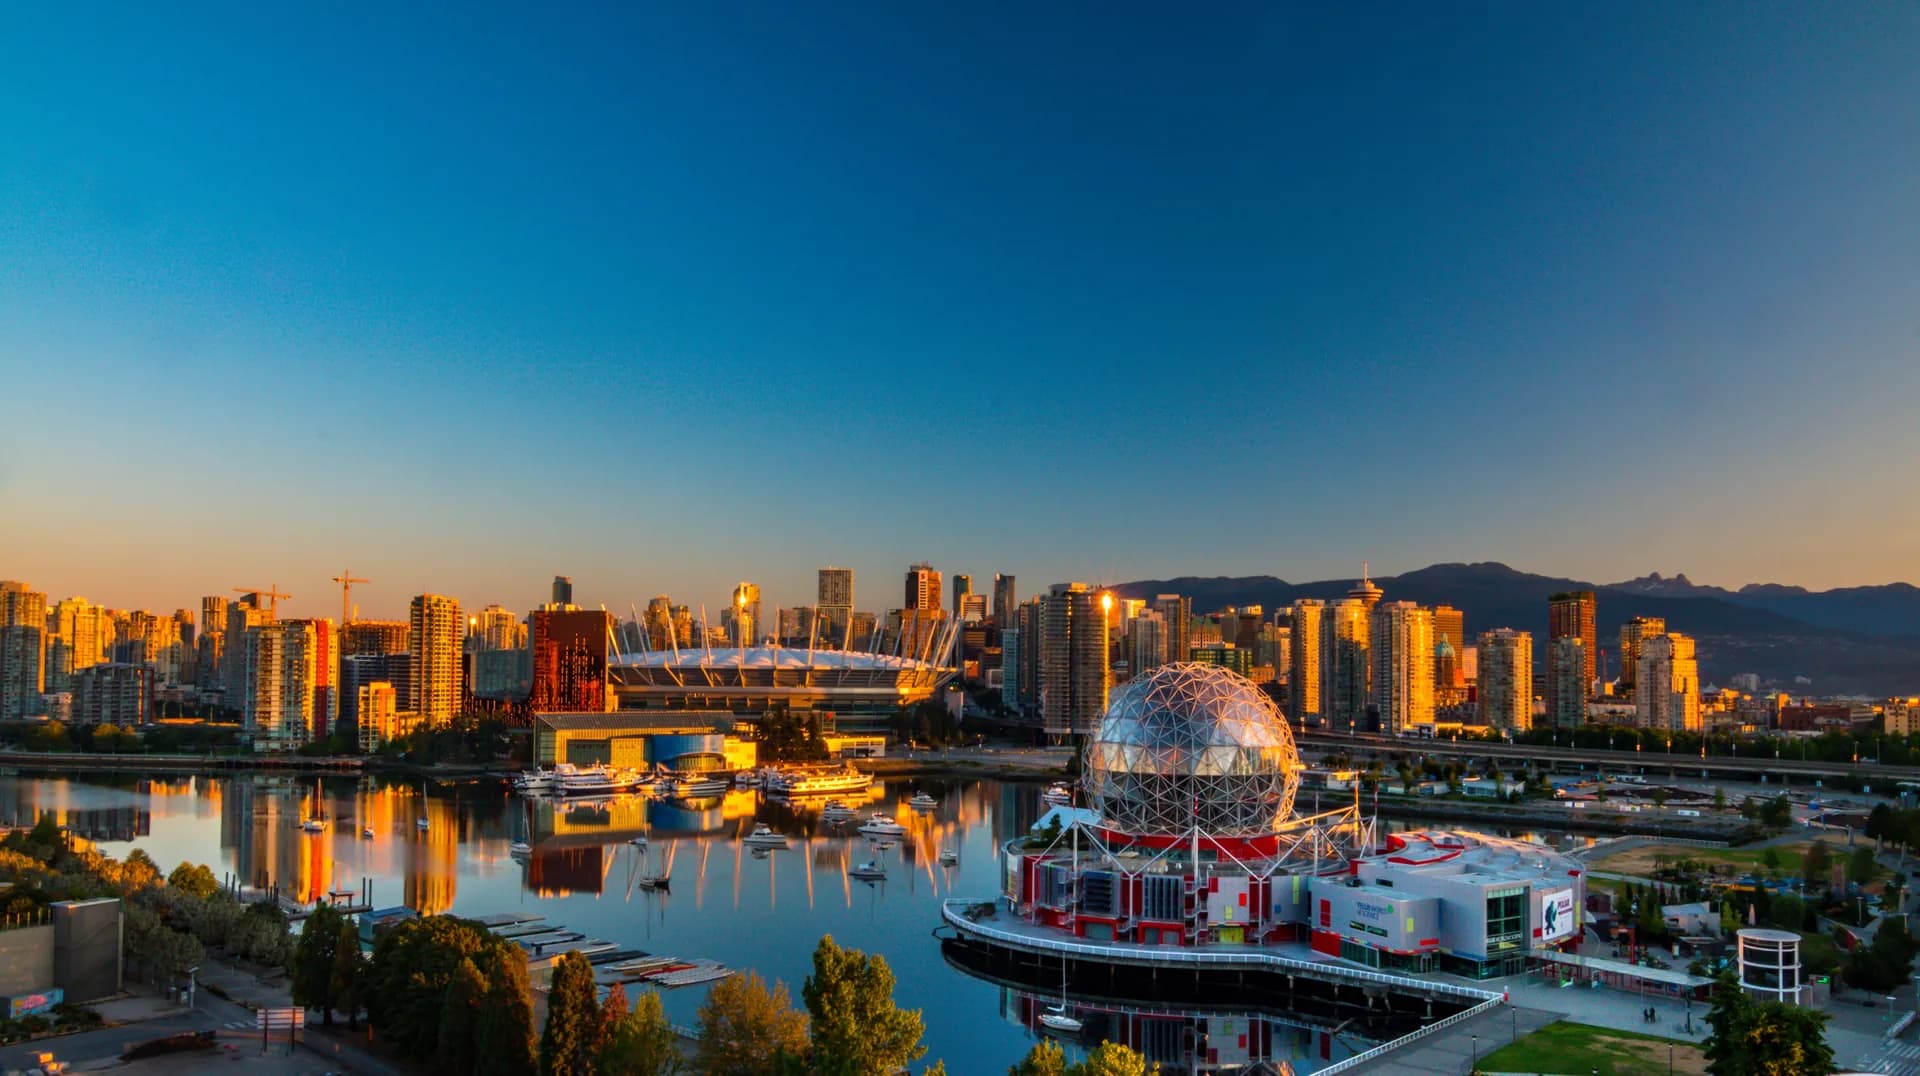
Escolha como e onde sua IA será executada.
Para empresas do Canadá e dos Estados Unidos, a implantação começa pela carga de trabalho. Compare modelos, locais de processamento, termos de dados e suporte para encontrar uma opção adequada.
Capacidade hospedada no Canadá
O plano da instalação inicial está centrado em Vancouver, no Canadá. Modelos devidamente licenciados poderão usar capacidade própria ou contratada aprovada, com termos que definam as solicitações, saídas, logs, backups e acessos abrangidos pelos compromissos de residência dos dados.
Implantações de provedores aprovados
Estamos avaliando o acesso a modelos por provedores autorizados. A escolha explícita considerará os modelos suportados, a região real de processamento e os termos de dados. Rotas alternativas aprovadas deverão preservar os mesmos limites acordados.
Nos dois países, a implantação será definida pelas necessidades da carga de trabalho. Regiões de processamento e compromissos de dados serão confirmados antes do acesso; o endereço do cliente ou um endpoint compartilhado não determina a residência dos dados.
Saiba por onde seus dados passam.
Avalie o caminho completo dos dados junto com o modelo, incluindo retenção e acesso.
Limites claros de processamento
Nossa política pretendida exclui prompts e saídas de clientes do treinamento de modelos. Os termos de processamento e treinamento de provedores externos serão informados para cada rota, sem presumir que sejam iguais aos nossos.
Retenção que você pode avaliar
Planejamos separar metadados de solicitações do armazenamento de prompts e saídas, com opções claras de retenção e exclusão. Opções de retenção zero exigirão suporte verificado em todo o caminho de processamento selecionado.
Adequação aos seus requisitos
Avalie a implantação conforme seus requisitos de segurança e conformidade, incluindo acesso, backups, suporte e compromissos contratuais. Dados de inferência, conta e cobrança terão seus próprios termos de localização e tratamento.
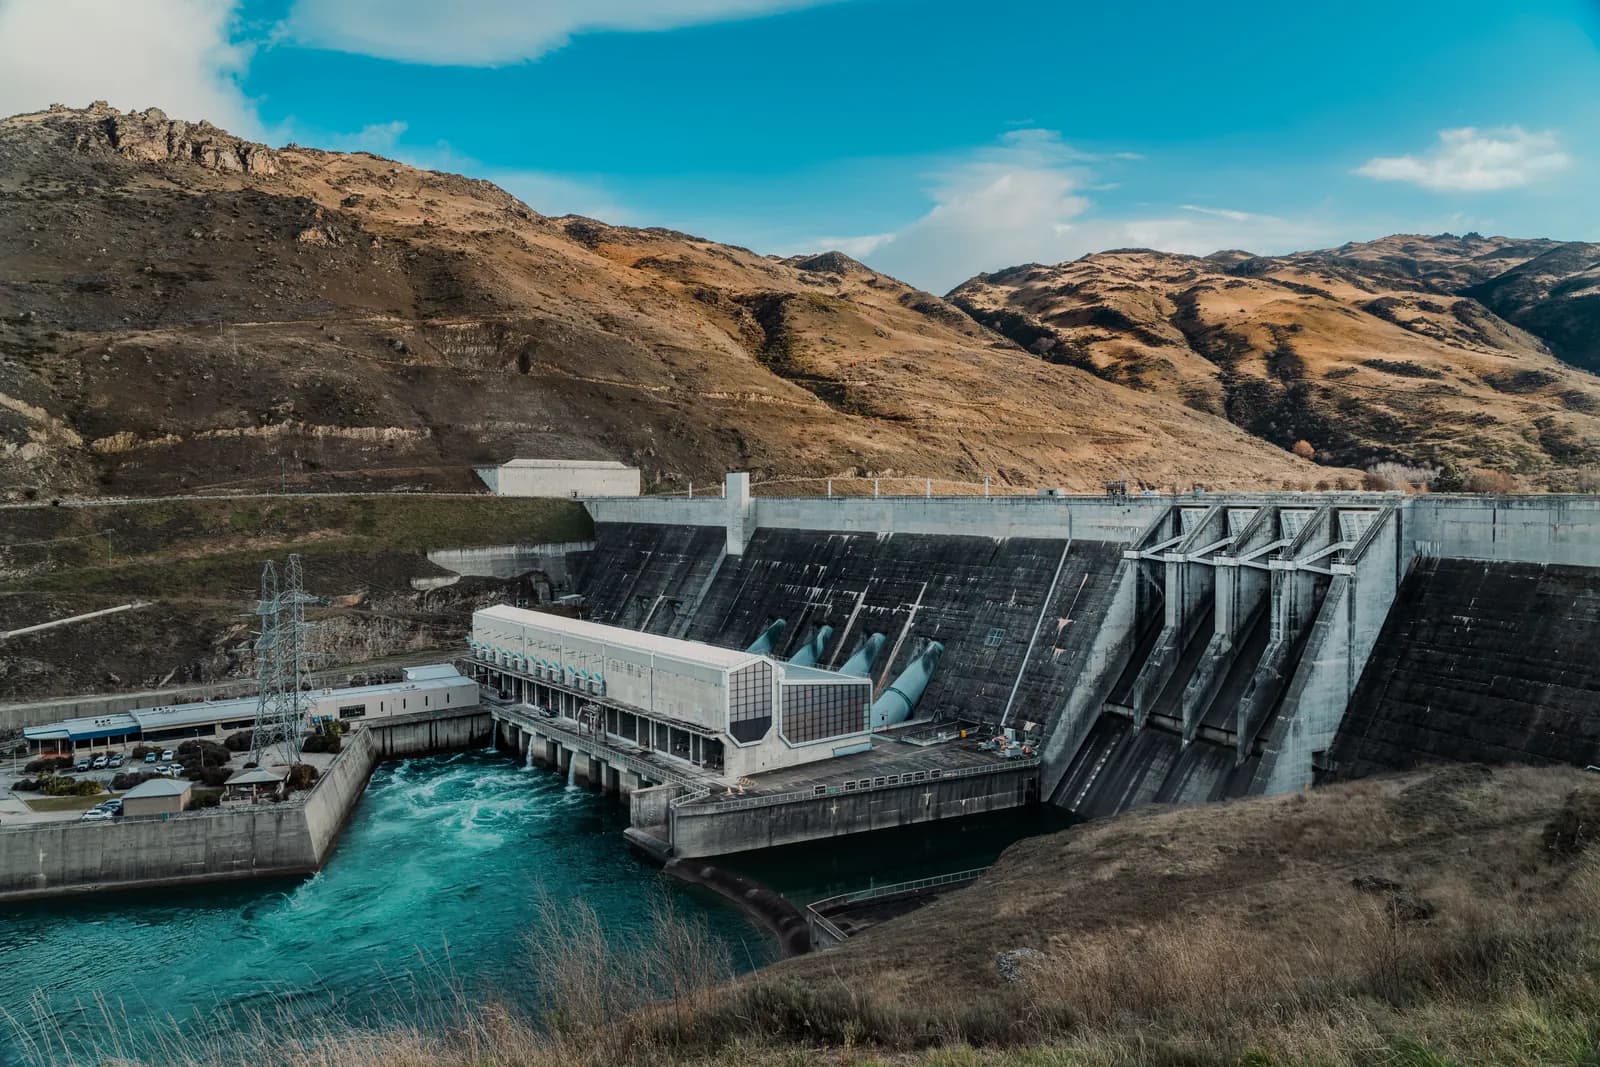
Uma base mais limpa para a IA.
O planejamento da instalação prioriza eficiência operacional e aquisição verificável de eletricidade limpa, com evidências que sustentem as declarações sobre energia.
Esses são objetivos de projeto e aquisição. O consumo da instalação, a origem da eletricidade e os relatórios ambientais dependerão do local e dos acordos operacionais finais.
Começar pelo serviço. Ampliar a capacidade.
Planejamos validar acesso a modelos e cargas de trabalho com equipes no Canadá e nos Estados Unidos, usando capacidade aprovada enquanto os planos do serviço e da instalação avançam.
Validar acesso e adequação dos modelos
Avaliar compatibilidade de solicitações, capacidades dos modelos, políticas de roteamento, medição de uso e necessidades do Figena, do Cilila AI e dos clientes independentes da API.
Testar com termos definidos
Planejar cargas limitadas com clientes selecionados em capacidade própria ou de parceiros aprovada, com limites, termos de dados, cobrança e suporte claros.
Expandir conforme a demanda
Ampliar opções de modelos e capacidade dedicada conforme as necessidades nos dois mercados, a experiência operacional e os requisitos de capacidade confirmados.
A janela de planejamento de 2028–2029 refere-se à instalação inicial. Os pilotos da API e o desenvolvimento da instalação podem avançar em etapas, com datas de acesso e locais de implantação anunciados separadamente após confirmação.
Perguntas sobre o plano
Como Accentrust, Figena e Cilila AI se relacionam?
A Accentrust é a empresa responsável pelo Figena e pelo Cilila AI. O Figena é seu principal software empresarial de finanças e operações; o Cilila AI é a camada de inteligência para compreender o contexto e avançar no trabalho. A Accentrust lidera a iniciativa de infraestrutura, com acesso à API planejado tanto para esses produtos quanto para seus próprios aplicativos.
Empresas do Canadá e dos Estados Unidos fazem parte do plano?
Sim. Canadá e Estados Unidos são mercados centrais. O acesso a modelos e os controles de uso planejados atendem equipes dos dois países e operações entre ambos. Local de implantação, escopo do serviço e termos de dados serão definidos por carga de trabalho.
Como posso explorar o acesso à API?
Estamos planejando os pilotos iniciais da API. O acesso público ainda não está aberto. Fale com nossa equipe sobre sua carga de trabalho, adequação dos modelos, requisitos de implantação e um possível piloto. Detalhes de acesso, modelos e preços serão publicados após confirmação.
Posso usar a API em meus próprios aplicativos?
Sim, esse é o modelo de serviço pretendido. O acesso à API está planejado como oferta independente para seus aplicativos, além dos serviços de modelos do Figena e do Cilila AI. As integrações continuam sujeitas à sua autorização.
Quais capacidades de modelos estão no escopo?
O foco inicial são modelos licenciados com chat e streaming validados usando solicitações no formato OpenAI. Cada modelo indicará limites de contexto, versões e suporte do endpoint a ferramentas ou saídas estruturadas. Embeddings, multimodalidade e outras compatibilidades de SDK fazem parte da avaliação de expansão.
Posso escolher processamento no Canadá ou nos Estados Unidos?
O local de processamento será associado a uma implantação verificada e a termos acordados. O plano da instalação inicial é em Vancouver, Canadá; provedores são avaliados por sua região real. Processamento residente nos Estados Unidos exigirá uma rota específica verificada antes do uso. Os termos abrangerão prompts, saídas, logs, backups, subprocessadores, acesso de suporte e rotas alternativas aprovadas.
Como funcionarão os preços e limites?
O planejamento comercial contempla acesso medido e capacidade reservada. Antes de um piloto ou contrato, você receberá as taxas de modelos e plataforma, unidades de cobrança, limites de solicitações e concorrência e regras para solicitações com falha, repetidas ou canceladas.
Poderei usar minhas próprias chaves de provedores?
BYOK está sendo avaliado como opção adicional. A avaliação cobre contratos com provedores, regiões de implantação, tratamento de dados, atribuição de uso e responsabilidade pelos custos. O escopo suportado será publicado após validação.
Como a API e a instalação se conectam?
O serviço poderá usar capacidade contratada aprovada e serviços de provedores enquanto o plano da instalação avança. Cada piloto informará a infraestrutura e os provedores efetivamente utilizados. A capacidade dedicada poderá crescer com a demanda de clientes do Canadá e dos Estados Unidos.
O que sua próxima carga de IA precisa?
Se sua equipe opera no Canadá, nos Estados Unidos ou nos dois países, conte-nos sobre aplicativos, modelos, uso esperado, orçamento e requisitos de processamento. Vamos explorar uma opção de acesso e implantação adequada.